jcode — опенсорсный AI-агент для кодинга в терминале
«Параллелизм — главный рычаг продуктивности. Обвязка важна не меньше модели. Инструменты разработки обязаны быть открытыми».
jcode — агент для программирования с открытым исходным кодом, написанный на Rust. Одна команда — и он установлен:
curl -fsSL https://jcode.sh/install | bashГотовые сборки для macOS, Linux и Windows, код на GitHub, лицензия MIT. Проект из Y Combinator.
01Миссия
Jcode построен на трёх ставках.
- Параллелизм — самый большой рычаг продуктивности в программировании. Вы не должны ждать, пока пишете код. Каждый момент, когда агент работает, — это момент, когда вы можете раздавать следующую задачу: запускайте ещё одну сессию вместо того, чтобы смотреть, как доделывает эта, — и ваша пропускная способность станет равна числу задач, которые вы способны раздать. Jcode позволяет держать десятки агентов параллельно, а дюжина агентов — это в дюжину раз больше результата, чем один.
- Обвязка (harness) важна не меньше модели. Одна и та же модель даёт очень разные результаты в зависимости от того, что её окружает: инструменты, до которых она может дотянуться, контекст, который она видит, память, которую она хранит, и петли обратной связи, ловящие её ошибки. Прогресс моделей приходит по своему собственному графику. Прогресс обвязки — наша работа, и он накапливается с каждым релизом модели.
- Инструменты разработки должны быть open source. Кодинг-агент читает ваш код, редактирует ваши файлы и запускает команды на вашей машине. Инструмент с таким размахом обязан быть прозрачным для изучения и модифицируемым: лучшие dev-инструменты всегда были теми, что пользователи могли открыть и переделать, — и исходники вашего агента должны быть вашими для кастомизации. Jcode распространяется по лицензии MIT, и всё, что команда замеряет и узнаёт, публикуется.
Настойчивость
Настойчивость — вторая половина интеллекта: большинство неудач агентов — это не неправильные ответы, а преждевременные выходы. Модели любят объявлять победу. Jcode сначала проверяет todo-лист: если ход завершился с незакрытыми задачами, обвязка автоматически «возвращает» модель к работе. Причём возвраты умны и в отношении сбоев: временные сетевые ошибки ретраятся, а неисправимые останавливают цикл вместо сжигания токенов. Тот же механизм управляет headless-запусками — jcode run продолжает итерации по задаче от хода к ходу, пока работа реально не будет сделана.
02Эффективность ресурсов
Узкое место массового параллелизма — эффективность расходования ресурсов. Запустите десятки агентов — и потребление RAM взлетает, что нереально для большинства потребительских машин: когда каждый агент занимает сотни мегабайт, вы запускаете несколько штук и ставите остальную работу в очередь за ними. Jcode это исправил. Его оптимизировали до костей, так что запуск ещё одного агента — не решение, которое нужно взвешивать, а десятки одновременных сессий — действительно возможны. И всё это без обмена на скорость. Каждое число ниже снято с реальных запусков реальных агентов на одной и той же машине.
RAM на каждую дополнительную сессию
Дополнительная пропорциональная память (PSS), которую добавляет каждый следующий клиент, когда один уже запущен. Десять сессий jcode стоят около 100 МБ — меньше половины одной сессии Claude Code.
| Инструмент | Доп. PSS | Относительно jcode |
|---|---|---|
| jcode | ~10,4 МБ | базовый уровень |
| Claude Code | ~212,7 МБ | в 20,5 раза больше RAM |
RAM на каждую дополнительную сессию, все инструменты
| Инструмент | Доп. PSS | Относительно jcode |
|---|---|---|
| jcode (локальные эмбеддинги выкл.) | ~9,9 МБ | базовый уровень |
| jcode | ~10,4 МБ | ×1,1 RAM |
| Codex CLI | ~21,6 МБ | ×2,2 RAM |
| pi | ~76,5 МБ | ×7,7 RAM |
| Antigravity CLI | ~86,4 МБ | ×8,7 RAM |
| Cursor Agent | ~157,5 МБ | ×15,9 RAM |
| GitHub Copilot CLI | ~158,1 МБ | ×16,0 RAM |
| Claude Code | ~212,7 МБ | ×21,5 RAM |
| OpenCode | ~318,4 МБ | ×32,2 RAM |
Время до первого ввода
Сколько проходит времени, пока вы реально можете печатать: от запуска до появления проверочного текста на отрисованном экране, по 10 интерактивных PTY-запусков на инструмент. Antigravity замерялся по внутреннему маркеру готовности ввода в его логе, потому что экран входа подавляет эхо проверочного текста.
| Инструмент | Время | Относительно jcode |
|---|---|---|
| jcode | 48,7 мс | базовый уровень |
| Antigravity CLI | 383,7 мс | ×7,9 медленнее |
| pi | 596,4 мс | ×12,2 медленнее |
| Codex CLI | 905,8 мс | ×18,6 медленнее |
| OpenCode | 1047,9 мс | ×21,5 медленнее |
| GitHub Copilot CLI | 1583,4 мс | ×32,5 медленнее |
| Cursor Agent | 1978,7 мс | ×40,6 медленнее |
| Claude Code | 3512,8 мс | ×72,2 медленнее |
Время до первого кадра
Сколько времени до первой отрисовки чего-либо на экране, те же 10 интерактивных PTY-запусков.
| Инструмент | Время | Относительно jcode |
|---|---|---|
| jcode | 14,0 мс | базовый уровень |
| Antigravity CLI | 383,5 мс | ×27,4 медленнее |
| pi | 590,7 мс | ×42,2 медленнее |
| Codex CLI | 882,8 мс | ×63,1 медленнее |
| OpenCode | 1035,9 мс | ×74,0 медленнее |
| GitHub Copilot CLI | 1518,6 мс | ×108,5 медленнее |
| Cursor Agent | 1949,7 мс | ×139,3 медленнее |
| Claude Code | 3436,9 мс | ×245,5 медленнее |
Видео с оригинального сайта: демо производительности и swarm-сессия — 20 агентов параллельно.
03Интеллект
Задача-оптимизация
Прогон стандартных бенчмарков на этих обвязках показал, насколько плохо они отражают то, что агенты реально умеют. Существующие бенчмарки стоят перед вынужденным выбором. Публичные утекают своими решениями в обучающие корпуса, поэтому очки измеряют запоминание и искажают реальные способности. Приватные этому сопротивляются, но требуют доверия к скрытому тестовому набору, дают меньше прозрачности и труднодоступны. Помимо этого выбора, у них два структурных изъяна. Они навязывают таймауты — агента штрафуют за то, что он тратит на задачу больше времени, хотя это ровно то поведение на длинном горизонте, которое мы хотим в агентах развивать. И они оценивают по грубой дискретной границе: разрыв между двумя очень разными моделями может проявиться как одна-единственная выполненная задача. Модель, решающая 70% бенчмарка, может вплотную стоять к оставшимся 30%, требующим качественно более высокого уровня способности, — и весь этот разрыв невидим между дискретными задачами. Поэтому авторы спроектировали новый класс бенчмарков со спецификацией:
- не загрязняется по построению: ответа, который можно зазубрить, не существует, поэтому всё может быть публичным;
- трудно насытить по построению: оценка идёт по глубине оптимизации, поэтому потолок остаётся открытым и за передним краем возможностей моделей;
- детерминирован по построению: та же посылка — тот же счёт, всегда;
- квантифицируем по построению: метрика следует из самого определения задачи, без рубрик и судей;
- непрерывен по построению: аналоговая ось очков вместо pass/fail, поэтому различия способностей видны как различия очков на каждом уровне, а время записывается, а не обрезается;
- устойчив к читерству по построению: в качестве стартовой точки даётся хорошая референсная реализация, поэтому поиск готовых решений в интернете — читерство лишь на низких уровнях способности. На переднем крае не остаётся реализаций для копирования, которые не были бы полезными рекомбинациями.
Такой дизайн заслуживает доверия сразу, потому что всё публично. Обучение на транскриптах предыдущей модели может даже немного помочь, но не даст лучшего счёта, пока модель действительно не обобщила: воспроизведение транскрипта лишь повторяет старый счёт, а чтобы его превзойти, нужно оптимизировать дальше запомненного — а это и есть способность, которую бенчмарк измеряет в первую очередь.
jcode bench v1 даёт три задачи по этой спеке: float-print, json-unescape и utf16-transcode. Выбраны они потому, что считаются за секунды и представляют собой чистое программирование реальных функций — полезных и реально выигрывающих от оптимизации: крутая петля, по которой агент может подниматься, на работе, которая реально уходит в библиотеки. Задачи подобраны и так, чтобы реализацию нельзя было переобучить под тест-сьют: корректность проверяется на всём пространстве входов, а не на выборке. Сравните с замером скорости grep прогоном по репозиторию Linux, где реализацию можно заточить именно под репозиторий Linux.
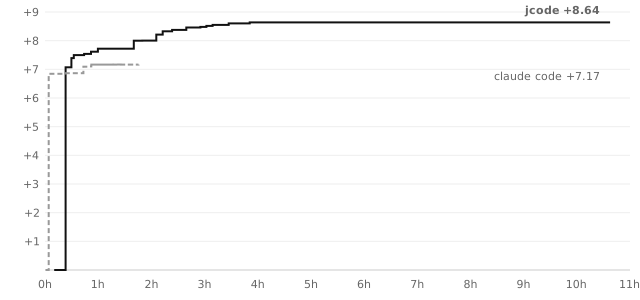
На графике — счёт агента во времени из одного пользовательского промпта. Время здесь коррелирует 1:1 со стоимостью и утилизацией токенов, потому что время tool-вызовов в этих задачах пренебрежимо мало. Оба прогона использовали Opus 4.8 с высоким thinking, одинаковые промпты, запускались одновременно, каждый остановился по собственному суждению. На float-print оба прошли полный корректностный гейт по всему пространству 232; jcode финишировал на +8.64 (ускорение в 398 раз) против +7.17 (×144) у Claude Code.
Оценка «восходимости» цели
Агенты максимально способны, когда у них есть метрика, по которой можно «восходить» (hill-climb). Вероятно, дело в том, что reinforcement learning обучает модели оптимизировать против сигналов вознаграждения, поэтому измеримая обратная связь помогает агентам продолжать улучшения на более длинных горизонтах, а дополнительные продуктивные итерации ведут к лучшему результату. Большинство пользователей никогда не пользуется этим в полную силу. Jcode делает это за пользователя, когда это применимо. Каждая цель агента получает оценку «восходимости» от 0 до 100 — в зависимости от того, насколько её прогресс реально квантифицируем и итерируем. Высокий балл недостоверен без заявленной объективной цели, к которой можно восходить. Когда цель получает низкий балл, обвязка возражает: переформулируй её в проверяемый объектив и построй измеритель, который это докажет. Без этого открытая задача оставляет агенту нечего итерировать — нет сигнала, благодаря которому следующая попытка могла бы стать лучше предыдущей.
Confidence stepping
Ещё одно направление — управление уверенностью модели. На графике ниже — уверенность по каждой попытке, доведение задачи до завершения и pass rate до и после «ступеней уверенности» на Terminal-Bench 2.1 (Opus 4.8). Полное исследование и транскрипты каждой попытки открыты на сайте проекта.
04Оптимизации
Та же дисциплина применяется ко всему, что стоит между вами и моделью: каждый токен, каждое попадание в кэш и каждый фоновый процесс спроектированы так, чтобы модель тратила свою ёмкость на вашу задачу, а не на оверхед.
Append-only контекст держит KV-кэш горячим от хода к ходу
Самый большой рычаг на латентность и стоимость — кэш промптов: провайдеры берут малую долю цены за токены, которые модель уже видела, а прочитать их обратно гораздо быстрее, чем пересчитывать attention с нуля. Jcode построен так, что этот кэш почти никогда не ломается. Префикс промпта стабилен, а разговор строго append-only — самый длинный возможный общий префикс переживает между ходами вместо того, чтобы молча инвалидоваться. То, что обычно сбрасывает кэш, вынесено из префикса: схемы инструментов берутся из фиксированного дискового кэша, MCP-инструменты анонсируются заранее, чтобы позднее подключение не переписывало ранние ходы, а динамический контекст — реколлы памяти и системные напоминания — размещается там, где наносит наименьший урон. Результат — стабильно высокий процент попаданий в кэш, меньшие счета и заметно более резкие ходы, особенно на длинных сессиях, где наивные агенты каждый ход заново платят за перечитывание всей истории.
MCP-инструменты готовы в момент старта сессии, без промаха кэша
Большинство агентов заставляют ждать: они блокируют старт, пока каждый MCP-сервер не завершит хэндшейк, или подключаются лениво — и тогда тихо инвалидируют кэш промптов модели при первом появлении инструмента, что стоит полного перечитывания разговора. Jcode не делает ни того, ни другого. На старте он мгновенно анонсирует все сконфигурированные MCP-инструменты из дискового кэша схем, так что модель видит полный список инструментов уже в первом запросе, и кэш промптов остаётся горячим. Реальные соединения к серверам устанавливаются в фоне, по первому вызову: если модель тянется к MCP-инструменту раньше, чем его сервер закончил подключаться, этот единственный вызов прозрачно дождётся хэндшейка, а всё остальное останется неблокирующим. В итоге вы можете начинать печатать, а агент — работать в момент создания сессии, MCP-инструменты включительно, без стартовой задержки и без штрафа по кэшу. Работает одинаково в интерактивном TUI, на сервере и в headless-режиме jcode run.
Долгая работа продолжается, пока агент продолжает думать
Попросите агента проследить за сборкой или тест-раном — и он обычно напишет скрипт с поллингом: sleep 500, одна проверка, сдаюсь. У jcode вместо этого фоновые инструменты. Запустите любую команду с run_in_background — и она станет задачей, которую агент может листать, читать по хвосту, инспектировать, отменять или дожидаться. Действие «wait» блокируется до завершения задачи или до следующей контрольной точки прогресса, так что агент просыпается по событиям, а не сжигает ходы в sleep-циклах. Обычной foreground-команде, выбежавшей за свой таймаут, ничего не грозит: jcode удочеряет её в фон, и задача переживает даже перезагрузку бинарника самого агента. Jcode разбирает вывод задач и рисует каждую живой карточкой в TUI: проценты, счётчики вроде «6/10 тестов», доли байт и ETA — из структурированных строк JCODE_PROGRESS или выведенные из обычного вывода. Агент может держать дюжину задач одновременно и позволить серверу разбудить себя, когда одна из них потребует внимания.
05Повседневный инструмент и открытость
Толкать передний край бессмысленно, если инструмент неприятен в использовании. Jcode — ещё и просто хороший повседневный dev-инструмент с интерфейсом, построенным для реальной терминальной работы: живые карточки фоновых задач, сессии, side-панели, слэш-команды вроде /commit-push, /todos и /subagent.
Код открыт, исследования открыты. Всё, что команда строит и замеряет, публикуется — включая транскрипты бенчмарков и провалы. Инструмент, который стоит так близко к вашей работе, должен быть тем, что можно читать, аудитировать и перекраивать под себя.
Self dev mode
Jcode изобретает новую форму настраиваемости — ту, что не ограничивает вас рамками плагинов и расширений. Скажите своему jcode-агенту войти в self dev mode — и он начнёт модифицировать собственный исходный код. Jcode оптимизирован под итерации над самим собой: вокруг саморазработки построена серьёзная инфраструктура, которая позволяет агенту редактировать, собирать и тестировать собственные исходники, затем перезагружать свой бинарник и продолжать работу в ваших (потенциально многих) сессиях — полностью автоматически.
Термин harness переведён как «обвязка» — это всё, что окружает модель: инструменты, контекст, память и петли обратной связи. Цифры бенчмарков взяты с главной страницы jcode.sh на дату перевода; графики и видео — из оригинала.